¿Qué es la IA multimodal?
La IA multimodal procesa texto, imagen, audio y video a la vez. Definición, funcionamiento, modelos, usos, riesgos e impacto en la búsqueda.
La IA multimodal ya forma parte de los productos de uso masivo de Google, OpenAI, Anthropic y Meta, que permiten consultar con texto, fotografías, voz o documentos dentro de una misma conversación. Lo que distingue a estos sistemas de los anteriores es que un solo modelo interpreta varios tipos de información y los relaciona entre sí.
La combinación de formatos lleva años en la investigación, pero se consolidó cuando los laboratorios pasaron de unir modelos separados a entrenar modelos que trabajan con varias modalidades desde el inicio. Hoy esa capacidad está presente en asistentes conversacionales, herramientas de análisis de documentos y buscadores.
¿Qué es la inteligencia artificial multimodal?
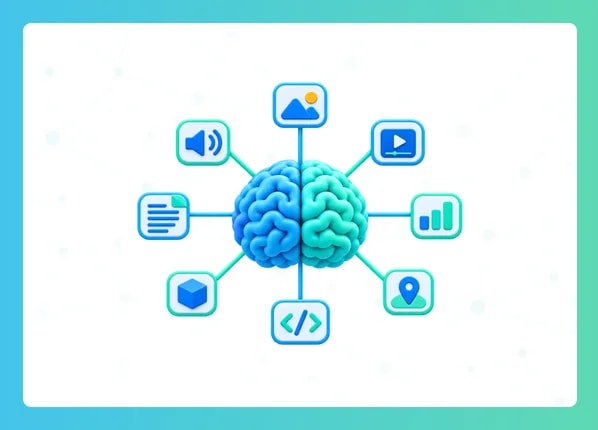
Es un tipo de sistema capaz de recibir, interpretar y relacionar información de más de un formato, como texto, imagen, audio y video, dentro de un mismo modelo. A partir de esa combinación, genera una respuesta que integra el contenido de todas las entradas.
Cada formato de información se denomina modalidad. Además del texto, la imagen, el audio y el video, otras modalidades posibles son las lecturas de sensores de movimiento, temperatura o distancia, y los datos de series de tiempo.
La IA unimodal, en cambio, trabaja con un único tipo de dato. Un modelo que solo clasifica imágenes o que solo procesa texto no puede relacionar el contenido visual con el textual. La ventaja de un sistema multimodal es que resuelve tareas en las que la respuesta depende de varias fuentes a la vez, como interpretar un gráfico y la pregunta que lo acompaña.
¿Cómo funciona un modelo multimodal?
Un modelo multimodal convierte cada formato en representaciones numéricas comparables y las procesa de manera conjunta. En muchos modelos, el proceso comienza con codificadores especializados por modalidad. Un codificador de imagen analiza los píxeles y uno de audio analiza la señal sonora, mientras que el texto se divide en unidades llamadas tokens.
Cada codificador produce embeddings, que son vectores numéricos que describen el significado de un contenido. Esos vectores se proyectan a un espacio compartido, donde la fotografía de un perro y la palabra "perro" quedan cerca una de otra. Ese espacio común es lo que permite que el modelo procese un mismo contenido sin importar el formato en que llegó.
El momento en que se combinan las modalidades define el tipo de fusión. En la fusión temprana, las entradas se unen antes de cualquier procesamiento profundo. En la fusión intermedia, las capas internas del modelo intercambian información entre modalidades durante el procesamiento. En la fusión tardía, cada modalidad se analiza por separado y los resultados se combinan al final.
También se distingue entre modelos nativamente multimodales y sistemas que encadenan componentes. Google describió Gemini en su presentación de Gemini como modelo multimodal nativo como un modelo preentrenado desde el inicio con distintas modalidades. En los sistemas encadenados, un componente transcribe el audio o describe la imagen y luego entrega ese texto a un modelo de lenguaje entrenado por separado. En ese traspaso puede perderse información que no queda registrada en el texto, como el tono de voz.
¿Qué diferencia hay entre un multimodal LLM y la IA generativa multimodal?
Un modelo de lenguaje multimodal se define por lo que puede recibir, mientras que la generación multimodal se define por lo que produce. Un LLM (por las siglas en inglés de large language model, o modelo de lenguaje de gran tamaño) es un modelo entrenado para comprender y producir texto. Un MLLM (multimodal large language model) es un LLM que usa el modelo de lenguaje como componente central y procesa, además, otras modalidades, según la revisión de la literatura sobre modelos de lenguaje multimodales de Yin y colaboradores.
Un sistema es generativo en varias modalidades cuando produce contenido distinto del texto, como imágenes, video o audio. Entrada y salida son criterios independientes, por lo que un mismo modelo puede ser un MLLM y, a la vez, generar contenido en varios formatos.
Comparación entre modelos unimodales, MLLM y generativos de imagen, video y audio
Tipo | Qué recibe | Qué produce | Ejemplo |
|---|---|---|---|
IA unimodal | Un único tipo de dato | Salida en esa misma modalidad | Un LLM que solo procesa texto o un clasificador de imágenes |
Modelo de lenguaje multimodal (MLLM) | Texto y otras modalidades, como imagen, audio o video | Habitualmente texto | Un modelo que responde preguntas sobre una fotografía o un PDF (documento en formato portátil) |
IA generativa de imagen, video o audio | Texto u otras entradas como instrucción | Imagen, video o audio | Nano Banana 2.1 para imagen y Gemini Omni Flash para video con audio |
¿Qué elementos componen un sistema multimodal?
Los elementos de un sistema multimodal son las modalidades que recibe o produce, y cambian según el tipo de modelo. Un MLLM se distingue por la variedad de formatos que puede recibir, mientras que un modelo generativo se distingue por los formatos en los que puede crear contenido.
Elementos de entrada de un MLLM
Texto: es el formato escrito con el que se formulan preguntas, instrucciones y contenidos. Ejemplos son una consulta en un chat, un correo o un artículo.
Imagen: es la información visual estática que el modelo interpreta. Ejemplos son una fotografía, una captura de pantalla, un gráfico o un diagrama.
Audio: es la señal sonora que el modelo transforma en información procesable. Ejemplos son una nota de voz, una llamada grabada o un sonido ambiental.
Video: es una secuencia de imágenes en el tiempo, con o sin sonido. Ejemplos son una grabación de pantalla, un clip de una cámara de seguridad o un tutorial.
Documentos: son archivos que combinan texto, tablas y elementos visuales en una sola pieza. Ejemplos son un PDF con gráficos, una factura escaneada o una presentación.
Datos de sensores: son lecturas de dispositivos que miden el entorno. Ejemplos son las cámaras, el radar y el LiDAR de un vehículo autónomo, o los sensores de movimiento y temperatura.
Series de tiempo: son registros de valores ordenados a lo largo del tiempo. Ejemplos son las lecturas de un equipo industrial, un historial de transacciones o un electrocardiograma.
Elementos de salida de un modelo generativo multimodal
Texto: es el contenido escrito que el modelo redacta a partir de una instrucción. Ejemplos son un resumen, una descripción de imagen o una respuesta.
Imagen: es el contenido visual estático creado por el modelo. Ejemplos son una ilustración, una fotografía sintética o el diseño de un producto.
Audio: es el contenido sonoro producido por el modelo. Ejemplos son una voz sintética, una pieza musical o un efecto de sonido.
Video: es una secuencia de imágenes generada a partir de una instrucción, con o sin audio. Ejemplos son un clip corto o una animación.
Contenido tridimensional: son modelos y escenas con volumen que pueden usarse en entornos digitales. Ejemplos son un objeto para un videojuego o una escena para realidad aumentada.
¿Quiénes desarrollan los principales modelos multimodales?
Los principales modelos multimodales provienen de Google, OpenAI, Anthropic y Meta. Las versiones cambian con frecuencia, por lo que el siguiente listado refleja la documentación oficial de cada empresa a noviembre de 2026.
Google Gemini: los modelos Gemini 4 Carbon y Gemini 4 Argon aceptan texto, imagen, audio, video y PDF como entrada, según la documentación de modelos de Gemini en Google AI Studio. La misma página indica que Google genera imagen con Nano Banana 2.1 y video con audio con Gemini Omni Flash.
OpenAI: los modelos de lenguaje GPT-6.1 (Sol y Terra) aceptan texto e imagen y responden en texto, de acuerdo con la lista de modelos de OpenAI para desarrolladores.
Anthropic Claude: los modelos actuales, Fable 5.2, Opus 5.5, Sonnet 5.5 y Haiku 5.5, aceptan texto e imagen y responden en texto, según la descripción general de los modelos de Claude.
Meta: Muse Spark es descrito por Meta como un modelo de razonamiento nativamente multimodal, disponible en Meta AI.
¿Qué límites y riesgos tiene?
Los sistemas multimodales presentan las limitaciones de los modelos de lenguaje y suman otras propias de combinar formatos. Los desafíos de los sistemas multimodales descritos por Splunk, como la alineación entre modalidades, la mayor demanda de datos de entrenamiento y la privacidad**, exigen controles adicionales a los de un modelo de texto.**
Alineación entre modalidades: cuando el modelo relaciona mal lo que recibe como imagen o audio con el texto, aparecen errores intermodales, como afirmar que una imagen muestra algo que no contiene.
Sesgos en los datos: los datos de entrenamiento reflejan desigualdades de representación, que el modelo puede reproducir al describir personas, voces o contextos.
Costo de cómputo: procesar imagen, audio y video demanda más recursos que procesar texto, lo que encarece el entrenamiento y el uso.
Privacidad: rostros, voces y documentos son datos personales o confidenciales, y su procesamiento requiere reglas claras de conservación y acceso.
Manipulación mediante instrucciones ocultas: una imagen o un audio pueden incluir órdenes que el modelo interpreta aunque una persona no las perciba.
Contenido falso: la generación de imagen, video y voz permite crear deepfakes, es decir, piezas falsas con apariencia verosímil, lo que complica verificar su origen.
¿Dónde se nota en la búsqueda y qué cambia para el GEO?
La multimodalidad se nota en buscadores como Google, donde una consulta puede combinar texto, imágenes, voz y documentos. Para la visibilidad en respuestas de IA, esto significa que las imágenes y los videos de un sitio también pueden formar parte de esas respuestas.
AI Mode, que funciona sobre Gemini, analiza una imagen junto con la pregunta y lanza varias búsquedas a la vez para luego combinar los resultados. Esa técnica se llama "fan-out", según la explicación de Google sobre cómo funciona la búsqueda visual con IA. Además, el campo de búsqueda rediseñado de Google acepta texto, imágenes, archivos, videos y pestañas de Chrome en una misma consulta.
El uso de estos formatos ya es habitual. Según el análisis de Google sobre los hábitos de búsqueda en AI Mode, más de una de cada seis búsquedas en Estados Unidos ya usa voz o imágenes, y AI Mode superó los mil millones de usuarios activos mensuales en el mundo.
Según la guía de Google sobre optimización para funciones de IA generativa, optimizar para estas funciones sigue siendo SEO. El documento aclara que no existe un schema especial para ellas y que los datos estructurados no son obligatorios. También señala que estas funciones pueden mostrar imágenes y video, por lo que seguir la documentación de SEO de imágenes y de video ya forma parte de la preparación.
En imágenes, la base es un texto alternativo descriptivo, que Google considera el atributo más importante para aportar metadatos sobre una imagen según su guía de SEO para imágenes en Google Images. A ese texto se suman nombres de archivo y texto cercano que describan el contenido. En video, la documentación de Google sobre SEO para video recomienda dedicar una página a cada pieza, marcarla con VideoObject e incluir miniaturas y sitemaps de video. Las transcripciones son una buena práctica de accesibilidad, aunque Google no las exige, y todas estas páginas deben ser indexables y elegibles para mostrarse con fragmento en los resultados.
La IA multimodal como nueva forma de buscar y responder
Los modelos multimodales integran texto, imagen, audio y video en un mismo sistema mediante codificadores, un espacio de representación compartido y distintas estrategias de fusión. Su adopción en buscadores y asistentes amplía los formatos en que una consulta puede formularse y en que una respuesta puede construirse. Al mismo tiempo, mantienen límites vigentes, como los errores entre modalidades, los sesgos, la privacidad y la manipulación, y en materia de visibilidad el criterio de Google sigue siendo aplicar buenas prácticas de SEO a texto, imágenes y video.
En Postedin diseñamos estrategias de SEO, GEO y AEO que consideran los distintos formatos de contenido, como video e imagen, para lograr visibilidad en la IA. Te invitamos a seguirnos en redes sociales para estar al tanto de estos temas y de cómo cambian los formatos de búsqueda y de respuesta.
Preguntas frecuentes
¿Qué es la IA multimodal y cómo funciona?
La IA multimodal es un sistema que recibe, interpreta y relaciona información de varios formatos, como texto, imagen, audio y video, dentro de un mismo modelo. Para ello convierte cada formato en vectores numéricos, los proyecta a un espacio compartido y los procesa de manera conjunta.
¿Cuál es la diferencia entre un LLM multimodal y la IA generativa multimodal?
Un LLM multimodal se define por lo que puede recibir: texto y otras modalidades, como imagen o audio. La IA generativa multimodal se define por lo que produce: imagen, video o audio. Son criterios independientes, así que un mismo modelo puede cumplir ambos a la vez.
¿Qué empresas desarrollan los principales modelos de IA multimodal?
Los principales modelos multimodales provienen de Google (Gemini), OpenAI, Anthropic (Claude) y Meta (Muse Spark). Gemini acepta texto, imagen, audio, video y PDF como entrada, mientras que los modelos de lenguaje actuales de OpenAI y Anthropic aceptan texto e imagen y responden en texto.
¿Cómo optimizar imágenes y videos para aparecer en las respuestas de IA de Google?
Se aplican las buenas prácticas de SEO para imágenes y video, porque Google indica que optimizar para sus funciones de IA sigue siendo SEO. En imágenes importan el texto alternativo descriptivo y los nombres de archivo. En video, una página por pieza, miniaturas, sitemap de video y páginas indexables.
¿Qué son los deepfakes y por qué son un riesgo de la IA multimodal?
Un deepfake es una pieza falsa de imagen, video o voz creada con IA que parece auténtica. Es un riesgo de la IA multimodal porque la generación de varios formatos facilita producir contenido engañoso y complica verificar su origen, lo que exige controles de procedencia y revisión antes de difundir o confiar en un material.